【教程】用 AI 翻译 Galgame:实时翻译与内嵌汉化补丁指南
用AI翻Galgame这事,随便聊聊
没汉化的Galgame,要么干等汉化组,要么硬啃生肉,要么被老机翻的黑话整得一头雾水。
现在有AI了,自己动手也不是不行。快的话几分钟就能搞出个能看的版本。下面这些就是我自己折腾过的路线,轻量玩法和硬核做补丁都有,你挑着看。
不过先说好,这些东西更新都挺快,你看到的时候界面可能已经变了。具体以GitHub和HuggingFace上的最新文档为准,别照着我这老版本死磕。
一、先想清楚你要哪种
两条路:
路线A:边玩边翻。 游戏跑着,工具实时抓文本,AI翻完悬浮窗显示。不用改游戏文件,上手最快,适合自己玩。
路线B:做内嵌补丁。 把文本提出来批量翻,再塞回游戏脚本,生成汉化补丁。适合分享,流程麻烦点,但成果完整。
翻译引擎是共用的,区别就在文本怎么提取、怎么回写。下面分开说。
二、几个能用的工具
实时翻译:LunaTranslator
这应该是目前Galgame实时翻译里用得最多的一个。支持HOOK注入和OCR识别,翻译接口基本都兼容,外挂和内嵌都能做。现在稳定版好像是v10.17.x,反正你去GitHub看最新版就行。
用法不复杂:启动游戏,开LunaTranslator,点“HOOK模式”,选游戏进程,等文本抓到了就开“自动翻译”,对话就变中文了。HOOK抓不到就切OCR,框选对话框区域识别翻译。
HOOK和OCR怎么选?HOOK直接从内存读,快且准,一般首选;但有些引擎加密厉害或者不支持,那就OCR兜底。另外还有个剪贴板模式,特殊场景能用。
有个小功能容易被忽略:HOOK模式下可以临时用OCR。比如游戏菜单、选项这种HOOK抓不到的,不用切模式,直接点“进行一次OCR”框选,识别完自动回HOOK继续。
提醒两件事。第一,这软件要注入DLL,杀毒软件容易误报,建议整个文件夹加白名单。第二,别放C:Program Files这种路径下,不然配置和缓存可能存不了。
内嵌补丁:GalTransl
GalTransl是把GPT提示工程和自动化脚本拼一起的Galgame翻译工具,专门做内嵌补丁。v7有桌面端图形界面(Tauri + React),不用敲命令行,支持深色模式、多项目管理、可视化流程。目前主要是Windows能用。
它几个主要优点:
- 支持GPT-4、Claude、DeepSeek、Sakura这些模型
- 有个“GPT字典”系统,可以给AI喂角色设定,人名和称谓翻得准一些
- 译前、译后、条件字典都有,细节能调
- 实时存缓存,断了能续
- 配合其他项目能一键解包和注入
从Release下最新压缩包,解压双击GalTransl Desktop.exe就能用,不用装Python。桌面端每个实例会自动开独立后端、分空闲端口,关一个窗口只停它自己的后端,其他窗口没事。
不过桌面端还在快速迭代,有些高级功能(比如自定义翻译规范)可能得手动改配置文件。遇到问题看GitHub Wiki或者加社区问吧。
术语表生成:KeywordGacha
翻长篇最烦的就是人名和专有名词不统一,同一个角色前面叫A后面叫B。KeywordGacha(KG)就是用AI自动生成术语表的工具,长篇里能统一名词、矫正人称、引导角色关系。
处理挺快,几分钟能分析完游戏文本。官方说跟人工词表比,术语命中率大概90%+。实际准不准,得看作品和文本类型。
KG作者最近出了个LinguaGacha,能把“术语生成+翻译+审校”一次性全自动跑完。不想分开操作多个工具的可以直接用那个。
另外,用了KG之后记得在发布页面显眼的地方说明一下,别装傻。
三、翻译模型怎么选
这直接决定翻出来能不能看。目前主要这几类:
专为ACGN优化的本地模型
Sakura系列(SakuraLLM / Sakura-GalTransl)是最早专门给Galgame翻译做优化的开源模型,sakuraumi和xd2333弄的。7B版本6G显存以上就能跑,对视觉小说脚本里的换行、控制符、ruby注音保留得还行。6G显存跑1线程,8G以上可以设4-10线程。14B版本(GalTransl-14B-v3系列)质量更好,Galgame和轻小说提升明显。不过14B 4bit量化(比如IQ4_XS)12G显存能跑,上下文长了显存会到15-17G,建议16G以上更稳。
Murasaki系列是新的ACGN翻译模型,带了原生Chain-of-Thought思维链。翻之前会先在内部把风格、动作流、人设、人称都过一遍,长难句解析好一些。最新版针对Galgame脚本加了不少训练数据,对话流和口语化文本理解更强。官方说Murasaki-8B在COMET指标上超了GPT-5和Claude-Opus-4.5(评测条件不同,看看就行)。
Murasaki支持三种模式:轻小说、剧本、短句,靠切System Prompt激活。一定得用对应的Prompt,不然效果打折。剧本模式专门针对Galgame台词,强调角色语气,傲娇腹黑什么的能抓一抓。
在线API模型
不想折腾本地部署,在线API省心。Claude在日语翻译这块口碑不错,有人叫它“日语翻译之王”,长句重组稳,不太崩。GPT-4系列和DeepSeek也是GalTransl官方支持的。
DeepSeek胜在便宜。具体费用看文本量和API定价。也有人说DeepSeek偶尔“加戏太多”,日常对话还行,剧情复杂的建议人工校对。
硬件要求参考
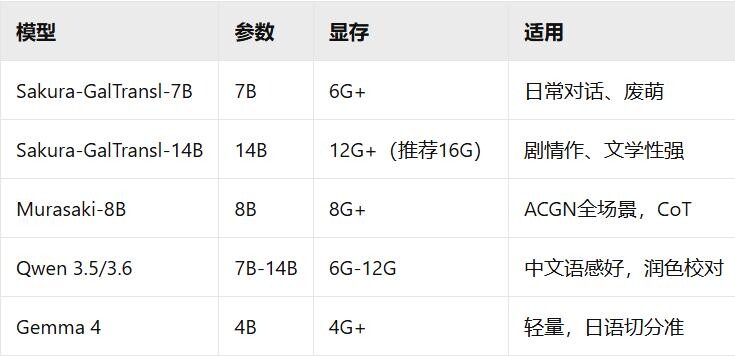
显存需求会随上下文长度变。比如Sakura 14B在上下文600时约14.9G,1800时约17.4G。不够的话用llama.cpp把部分层卸载到CPU/内存,但速度会掉得明显。
四、实操:实时翻译
拿LunaTranslator + 在线API举例。
第一步,搞API。 去服务商申请Key。DeepSeek和火山引擎便宜快,推荐先拿DeepSeek试水,成本极低。
第二步,配LunaTranslator。 打开,设置里选API模式,填Base URL和API Key,开启你用的模型通用接口。
第三步,写Prompt。 这个挺关键。在翻译设置里自定义System Prompt,告诉AI你要什么风格。比如:“你是一位资深的Galgame汉化组成员,请将以下日语翻译成自然、流畅的中文,注意保持女主角‘毒舌’的人设,禁止使用机翻感强的词汇。”
第四步,启动游戏。 运行Galgame,LunaTranslator点HOOK模式,选进程。文本抓到后调悬浮窗透明度,盖在对话框上,就跟内嵌字幕差不多。
五、实操:做内嵌汉化补丁
想分享出去,GalTransl有一套完整流程。
大概就是:识别引擎 → 解包拿脚本 → 提日文 → AI翻 → 构建中文脚本 → 回写封包。
GalTransl v7桌面端已经把这门槛降了不少。Release下最新压缩包,解压双击GalTransl Desktop.exe,不用Python不用依赖。
引擎解包注入方面,GalTransl有个配套的UniversalInjectorFramework,里面好几个DLL,一般先试winmm.dll。如果游戏有现成MTool或Translator++支持,也可以先用那些提文本,再导进GalTransl翻。
⚠️ 重要提醒:用GalTransl翻完没做全文校对/润色就发布的话,务必标“GPT翻译/AI翻译补丁”,别标“个人汉化”。这是诚实问题,也是对汉化组的基本尊重。
六、提升质量的一些歪招
1. 术语表
SakuraLLM从v1.0开始有术语表功能,可以自定义“原文-译文”对照,模型推理时会严格遵循。Galgame术语表至少该有:角色名、地名、组织名、特殊技能/道具、世界观专有词。
Murasaki也支持术语表,专门做过特化训练,支持Prompt级注入。不想手动整理就用KeywordGacha自动提。
2. 给AI喂角色设定
这是GalTransl“GPT字典”的核心用法。项目字典里可以给每个角色定义中文翻译和设定(性别、年龄、职业、性格),AI会自动调人称和称谓。
格式是日文 [Tab] 中文 [Tab] 解释,中间用Tab键。比如:
フラン 芙兰 名字,女士,老师
这样GPT翻“フラン先生”就会出“芙兰老师”而不是“芙兰医生”。
注意设定别写太复杂,不然AI会脑补些奇怪东西。推荐只写核心设定和总是翻错的词。一般人名进项目字典,通用词汇进通用字典。
3. 控制符和特殊格式
Galgame脚本里一堆控制符(换行、颜色、Ruby注音),AI翻的时候容易丢或错位。Murasaki-APE-Aligner-2B就是专门修这个的,用了40种以上游戏引擎、超过1000种控制符数据训练,能自动对齐修复损坏的控制代码。
用法简单:原文和AI初翻按JSON格式输入,模型输出修复格式后的纯文本,不改译文内容。
另外,Sakura-GalTransl系列对Galgame控制符保留还行,但对RPG Maker这类非Galgame引擎适配有限,毕竟训练语料100%是Galgame文本。
4. 人称和省略主语
日语大量省略主语,AI翻译容易懵。Murasaki的CoT会先在内部确认说话人身份,再定人称代词,对“施动者/受动者模糊”和“人称混淆”有点用。配合GPT字典里的角色设定效果更好。比如字典写了“芙兰是女性老师”,AI就不会搞错人称。
七、现在翻出来到底能看吗
说实话,比两三年前强太多了。有玩家说:“就连AI直接过一遍,都比以前机翻强太多。”
但也有理性的:废萌、拔作已经没啥问题,剧情作还是差些,悬疑类AI可能“看不懂文本”。另一个常见问题是翻译腔,意思对了但读起来没人味。
实用建议:日常对话和废萌,AI翻直接玩;剧情复杂或文学性强的,建议自己对照原文润色一下。有条件用两个模型AB对比,取长补短,效果会好点。
八、想马上试的话
最省事的路径:
第一步: GitHub搜LunaTranslator,下载解压即用。
第二步: 注册个DeepSeek API,几块钱够翻好几部,在LunaTranslator里配好接口。
第三步: 设个简单Prompt,告诉AI“你是Galgame汉化组成员,翻译自然口语化”。
第四步: 启动游戏,HOOK抓文本,开玩。
玩顺了再考虑本地部署Sakura或Murasaki,或者拿GalTransl做补丁分享。
九、几个容易踩的坑
随便提一嘴,爱看不看:
量化选择:Sakura-GalTransl 7B有IQ4_XS、Q4_K、Q5_K、Q6_K等量化。6G显存建议Q4_K或IQ4_XS,8G以上Q5_K或Q6_K。Murasaki-8B也有IQ4_XS,显存更小。
LunaTranslator翻译缓存:实时翻译时同一句可能反复抓,浪费API钱。建议开翻译缓存,别重复翻。
GalTransl的sjis替换模式:有些日文游戏用Shift-JIS编码,中文显示不出来。GalTransl有sjis替换模式,具体看Wiki。
在线API并发限制:批量翻译注意服务商速率限制。GalTransl能设并发数和重试,合理配置免得被封。
AI翻译补丁标注:现在有些社区(比如Kungal)对AI补丁标注有明确规范,2DFan那边也在变。除了标“AI翻译”,有的还要求写模型和版本号。发之前先看版规。
差不多就这些。工具都是开源,GitHub上找。模型HuggingFace下。用的时候遵守开源协议和版权,发补丁记得标AI来源。就这样吧。